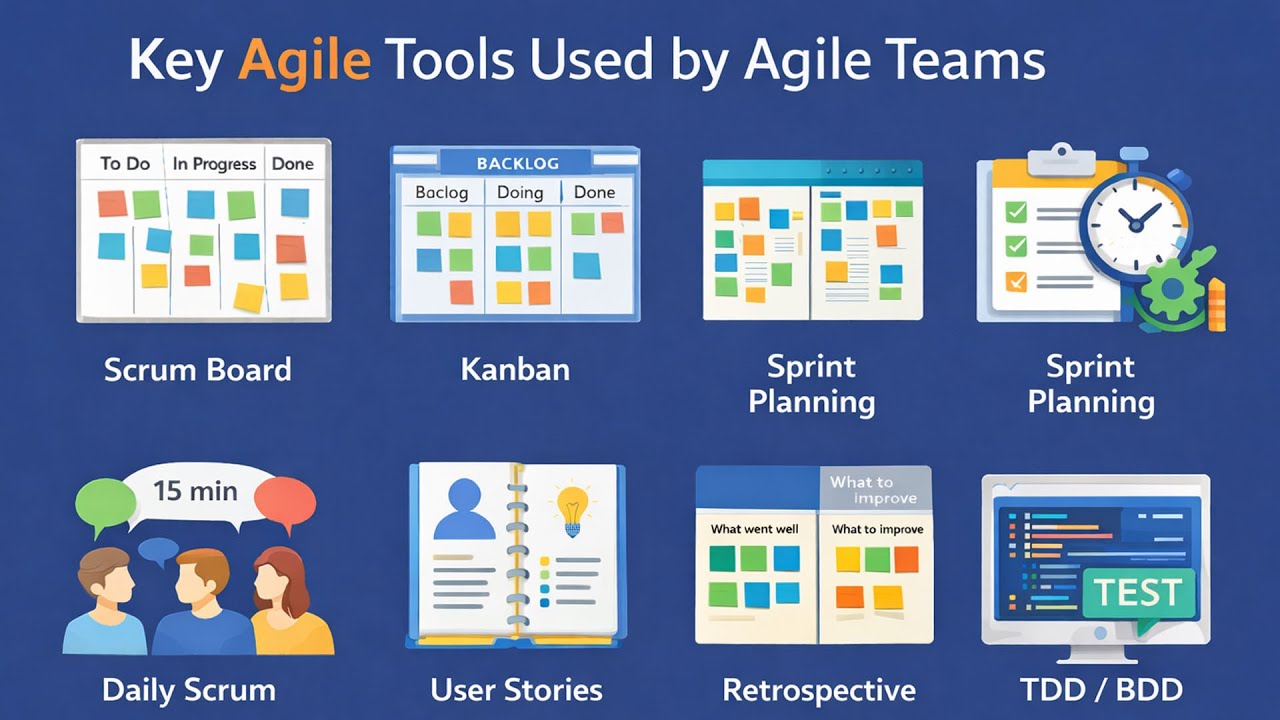
Agile-инструменты это не набор модных слов и не «церемонии ради церемоний», а практические механизмы, которые помогают команде делать три вещи одновременно: снижать неопределённость, то есть быстрее узнавать правду о рынке, пользователе и технологии; повышать предсказуемость поставки за счёт маленьких порций, коротких циклов и прозрачного потока; и улучшать качество решений и продукта через обратную связь, измеримость и улучшение процесса. Ниже собран «основной набор», который обычно и отличает зрелую agile-команду от той, где Agile сводится к доске и митингам, а инструменты живут сами по себе.
1. Смысл и направление: чтобы команда понимала «зачем»
Первый слой инструментов удерживает команду от хаотичных хотелок и «побочных квестов». Product Vision / Mission фиксирует, для кого продукт, какую проблему он решает, почему именно сейчас и чем принципиально отличается; рабочая форма это 1-3 предложения плюс примеры «что мы делаем / что мы не делаем». Ошибка здесь типична: vision превращают в лозунг вроде «делаем мир лучше», который не помогает выбирать. Outcome-цели (OKR) смещают разговор с «сколько задач закрыли» на «что изменилось»: цель описывает направление и ценность, а ключевые результаты это измеримые изменения в поведении или бизнесе, обычно 1-2 цели на цикл (квартал/PI/месяц) и 3-5 измеримых KR; провал наступает, когда KR подменяют активностью («выпустить 10 фич»). Если применимо, поверх этого ставят North Star / One Metric That Matters, метрику, которая отражает delivered value пользователю и связана с ростом, помогая согласовать продукт, маркетинг, продажи и саппорт. Брать вместо неё vanity-метрику («DAU любой ценой») опасно: команда начинает оптимизировать шум.
2. Формулирование работы: чтобы делать правильные вещи
Когда общее направление задано, следующий слой инструментов помогает превратить его в конкретную работу, а не в поток случайных задач. User Story + Acceptance Criteria переводит потребность в проверяемую поставку по формуле «как [роль] я хочу [действие], чтобы [ценность]», где критерии приёмки обязательно наблюдаемы, то есть однозначно говорят, что считается сделанным. Частая ошибка это раздуть историю до «мелкого ТЗ на 2 страницы» или, наоборот, написать её без ценности. Jobs-to-be-Done (JTBD) не даёт спутать «кто пользователь» с «зачем он нанимает продукт»: задачу описывают как прогресс в конкретной ситуации по цепочке триггер → барьеры → ожидаемый результат; бесполезно, когда JTBD висит красивым ярлыком, а backlog остаётся фичевым. Impact Mapping связывает цели → поведение → фичи, разворачивая цель через акторов и изменения их поведения к тому, что может это вызвать (инициативы и фичи), и ломается ровно там, где команда прыгает сразу к фичам, минуя изменение поведения. Story Mapping помогает видеть продукт как сценарий, а не список задач: по горизонтали идут шаги сценария, по вертикали идёт глубина, где MVP сверху, а детали ниже; карту вредно рисовать один раз «для презентации» и потом не обновлять.
3. Бэклог, планирование и прогнозирование: обещать меньше и точнее
Отдельные истории и цели нужно где-то собирать и упорядочивать, иначе правильные вещи тонут в потоке идей. Product Backlog это единый источник правды о том, что команда может делать дальше, поэтому его элементы должны быть сопоставимы по размеру и ясности и регулярно уточняться; худшее, во что он превращается, это склад идей без приоритетов и критериев успеха. Само уточнение выносят в Refinement (Grooming), где заранее проговаривают зависимости, критерии, разбиение и риски, чтобы в спринте внезапно не оказалось, что ничего не понятно; вырождается он в бесконечные обсуждения «как именно реализовать». Чтобы говорить аргументированное «нет» и держать фокус, нужна приоритизация: RICE, WSJF, Cost of Delay или Kano на выбор, но одну модель берут как базовую и используют постоянно, а не меняют метод под желаемый результат.
На основе бэклога строится планирование. Sprint Planning нужен, чтобы команда взяла столько, сколько реально способна закончить: цель спринта → набор задач → план достижения → проверка capacity; провал: когда это превращается в «раздачу задач сверху» или «угадайку на часы». Sprint Goal связывает работу спринта в единый смысл и помогает принимать решения по ходу, если сформулирован про результат и ценность, а не как «закрыть 30 задач». Для синхронизации со стейкхолдерами и зависимостями служит лёгкий Release Planning / Roadmap, который лучше строить вокруг outcomes и проблем, а не «дат фич», и который опасно превращать в контракт «к 15 числу точно будет».
4. Управление потоком: Kanban против хаоса
Когда работа сформулирована и распланирована, её ещё нужно провести через поток без заторов. Kanban Board делает работу видимой и вскрывает пробки, но только если колонки отражают реальные стадии, например, Ready → In progress → Review → Done; доска, не соответствующая процессу, мертва, в ней никто не живёт. WIP-лимиты снижают переключения, ускоряют завершение и делают блокировки заметными; их ставят на самые «забитые» стадии (обычно Dev/Review/QA), и они бесполезны, когда заданы формально, а команда при перегрузе всё равно «начинает новое». Explicit Policies убирают скрытые ожидания и конфликты «а я думал…»: явно фиксируют, что значит «Ready» и «Done», когда задача считается заблокированной и какой SLA на review, при условии, что правилам действительно следуют. Classes of Service позволяют управлять срочностью системой, а не истерикой: Expedite для инцидентов, Fixed Date для закона или контракта, Standard и Intangible для техдолга; как только всё становится Expedite, поток рушится.
Ранние признаки, что поток начинает сбоить, обычно заметны прямо на доске:
- задачи подолгу стоят в Review или QA: узкое место оказывается не там, где его ждут;
- заблокированных карточек становится больше, а владельца у самой блокировки нет;
- работу всё чаще помечают как Expedite, хотя настоящего инцидента за этим нет;
- в «In progress» тесно, а «Done» почти не пополняется.
5. Синхронизация и улучшение процесса
Когда поток налажен, команде нужно регулярно сверяться по нему и на ходу его улучшать. Daily Stand-up существует, чтобы быстро снять блокировки и свериться с целью, поэтому на нём обсуждают работу, а не «отчитываются»; хороший формат крутится вокруг трёх вопросов: что продвигает нас к цели, что мешает и что нужно от команды сегодня. Если он превращается в микроменеджмент и пересказ календаря, смысл потерян. Sprint Review / Demo даёт регулярную обратную связь от бизнеса, пользователей и смежников: показывают работающий инкремент и обсуждают эффект и следующие шаги, а не листают слайды вместо демонстрации результата. Ретроспектива это инструмент системного улучшения скорости, качества и взаимодействия, но работает она лишь тогда, когда из неё выходят 1-2 конкретных изменения на следующий цикл с владельцем и проверкой эффекта, а не «поговорили и забыли».
6. Качество и готовность: чтобы «сделано» означало «работает»
Быстрый поток обесценивается, если на выходе получается сырьё, поэтому следующий слой инструментов удерживает планку качества. Definition of Done (DoD) задаёт единое понимание качества поставки и потому должен быть конкретным: код в main, тесты пройдены, мониторинг настроен, документация обновлена, фича за флагом, аналитика событий добавлена; беда, когда DoD размыт до «проверено» без критериев. Дополнительная командная договорённость это Definition of Ready (DoR): аккуратно применяемый, он снижает риск взять в работу «сырьё» и держится на минимуме. Прежде чем тянуть историю в спринт, стоит убедиться в немногом:
- ценность истории ясна и сформулирована, а не держится в голове у одного человека;
- есть наблюдаемые критерии приёмки: видно, что именно считать сделанным;
- критических неизвестностей не осталось: спайк, прототип или обсуждение убрали главный риск заранее;
- зависимости проговорены, и снаружи ничто не мешает начать.
При этом DoR нельзя превращать в бюрократический фильтр «чтобы ничего не брать». Code Review, Pair и Mob Programming дают качество, распространение знаний и снижение «автобус-фактора», при условии, что review ищет риски и улучшает дизайн, а не работает стиль-полицией. CI/CD и Feature Flags обеспечивают безопасные маленькие релизы, быстрые откаты и эксперименты; если же релизы неделями копят, боясь выкатывать, риск только растёт.
7. Измерение и прозрачность: управлять реальностью, а не ощущениями
Метрики потока не бывают «хорошими» или «плохими» сами по себе: всё решает, как именно ими пользуются, и одна и та же цифра либо помогает управлять, либо толкает команду играть в числа.
- Burndown / Burnup работают, пока показывают динамику выполнения и объём для Scrum-команд; ломаются, как только график используют как кнут и люди начинают «рисовать» цифры.
- Cumulative Flow Diagram (CFD) работает для Kanban и гибридов, делая видимыми WIP, узкие места и стабильность потока: смотреть надо туда, где «раздувается» слой, обычно Review или QA; ломается, когда CFD собирают, но процесс по нему не меняют.
- Lead Time / Cycle Time / Throughput работают по принципу «сначала мерить, потом улучшать 1-2 узких места»; ломаются при попытке «ускорить всё сразу», жертвуя качеством.
- Velocity (если используете story points) работает для внутреннего прогнозирования самой команды; ломается как KPI, стоит начать сравнивать velocity разных команд или привязывать её к оценке людей.
8. Работа с неопределённостью: не ставить «на удачу»
Даже отлаженный поток буксует там, где команда действует наугад, поэтому часть инструментов прямо нацелена на риск. Spike это исследовательская задача, чтобы быстро снять технический или продуктовый риск; её ограничивают по времени и фиксируют вопрос и ожидаемый артефакт (прототип, решение, оценку рисков), иначе spike вырождается в бесконечное «покопаться». Прототипирование и discovery-эксперименты, будь то интервью, прототип-тесты, fake door, concierge или A/B, проверяют гипотезы до дорогой разработки и теряют смысл, если их делают «для галочки», не связывая с решениями в backlog. Risk Board / Pre-mortem позволяет заранее увидеть, где может сломаться запуск: команда спрашивает «представим, что провалились, почему?» и строит план снижения рисков; толку мало, если риски записали, но не закрепили владельцев.
9. Взаимодействие со стейкхолдерами
Ни один из этих инструментов не работает в вакууме, вокруг команды всегда есть заказчики и смежники. Stakeholder Map вместе с регулярными синками согласует ожидания и снижает «внезапные прилёты», ведь общаться только когда «горит» как раз и создаёт эти прилёты. Decision Log уменьшает повторные споры и повышает ответственность, если фиксирует, что решили, почему, на каких данных и когда пересмотр; без него решения принимаются в чатах и теряются. Working Agreements снижают трение, проговаривая, как мы работаем, как решаем конфликты, как отвечаем и как эскалируем, при одном условии: их не «пишут на стене и забывают».
10. С чего начинать: минимум, зрелость и типичные ловушки
Если нужно стартовать быстро, минимально жизнеспособной agile-команде хватает семи вещей: backlog с понятными элементами (ценность плюс критерии приёмки); канбан- или спринт-доска, отражающая реальный поток; ежедневная 15-минутная синхронизация по блокировкам; Review раз в 1-2 недели, где показывают работающий результат; ретроспектива раз в 2 недели с 1-2 улучшениями, не больше; DoD, задающий, что значит «сделано»; и хотя бы вручную снятые метрики потока, cycle time и throughput.
Зрелый уровень добавляется, когда хочется управлять предсказуемо: WIP-лимиты и явные политики (Ready/Done/Blocked); CFD с регулярным улучшением узких мест; классы обслуживания (Expedite/Standard/Fixed Date и т. д.); встроенные в поток discovery-инструменты, прототипы и эксперименты; decision log и прозрачная приоритизация; CI/CD, feature flags и дисциплина небольших релизов; и, наконец, цели по результату (OKR/outcome), связывающие работу с измеримым эффектом.
Инструменты при этом легко «есть», не получая пользы, и ловушки повторяются из команды в команду. Церемонии превращаются в театр, когда митингов много, а блокировки не снимаются и решения не фиксируются. Agile становится ускорителем хаоса, если начали «быстрее делать», не определив, что важно. Оценки, ставшие KPI, толкают команду играть в цифры, когда story points превращают в меру продуктивности. Отсутствие «финиша», когда много In progress и мало Done, выдаёт нехватку WIP-лимитов и явных правил. А нулевая обратная связь, без review, демо и измеримости, отрывает команду от реальности.
Если прокачивать всё это по порядку максимального эффекта, последовательность такая: сначала сделать работу видимой (доска и реальные стадии), затем уменьшить незавершёнку через WIP-лимиты, договориться о качестве в DoD, регулярно показывать работающий результат на review и демо, регулярно улучшать процесс ретроспективой с конкретными изменениями, подключить метрики потока (cycle time, throughput, CFD) и лишь потом привязать работу к outcomes, то есть к целям по результату, а не по активности. Порядок не случаен: видимость и ограничение незавершёнки дают эффект раньше, чем метрики и цели, которым без них попросту не на что опереться, и именно поэтому попытка начать с целей и дашбордов почти всегда буксует.