На квартальном ревью показывают 40 завершённых A/B-тестов, у дюжины значимый результат, а roadmap на следующий квартал выглядит ровно так, как выглядел бы без единого эксперимента. Цифры собраны, но ни одно решение от них не зависело.
Так бывает даже при корректной статистике. Тест помогает только тогда, когда команда заранее договорилась, какое решение изменит его результат. Если такой договорённости нет, эксперименты превращаются в фоновую активность: создают ощущение работы с данными и не снижают неопределённость.
Разомкнутый контур выглядит как слабость продакта
A/B-тест проще всего понять через его границы. Он начинается с вопроса о выборе пользователя и заканчивается управленческим решением. Варианты, счётчики и статистика существуют только ради этого решения.
Когда тесты не дают роста, виноватым обычно назначают продакт-менеджера: он отвечает за гипотезы, метрики и интерпретацию. Объяснение поверхностное. Во многих командах от продакта ждут активности, и число запущенных экспериментов становится косвенной метрикой его работы. Человек оптимизируется под то, что считают: запускает тесты, даже если они не касаются ни одного важного выбора.
Ответственность в таких случаях возлагают на человека, хотя сбой системный. Даже сильный продакт не извлечёт пользы из A/B-тестов, если эксперименты не связаны с реальными решениями. То, что выглядит как персональная слабость, на деле оказывается дефектом процесса, и чинить его нужно на уровне правил: смена людей тут мало что даст.
Контур рвётся на входе и на выходе
Контур управления через A/B-тестирование должен быть замкнутым: бизнес-вопрос, гипотеза, эксперимент, решение. Если связь рвётся на любом этапе, эксперимент теряет смысл. Чаще всего она рвётся в двух местах.
Первый разрыв на входе. Тест запускают без вопроса: проверяют идею, кнопку или текст, не понимая, какую неопределённость хотят снять. Тогда любой результат легко истолковать как угодно.
Второй разрыв на выходе. Тест завершён, данные есть, но решение уже принято заранее или откладывается. Результат становится интересным наблюдением. Продакт формально сделал свою часть работы, продукт не изменился.
Оба разрыва подпитывают друг друга. Без вопроса на входе выход всегда можно подогнать под готовое решение. А если решение всё равно принято заранее, вопрос формулировать никто не станет. Поэтому разомкнутый контур устойчив: новыми тестами его не починить, чинит только требование назвать вопрос и решение до запуска.
Три вещи записывают до запуска
Первая вещь: бизнес-вопрос. «Увеличить конверсию» вопросом не является. Вопрос звучит так: «Уходят ли покупатели с шага оплаты, потому что не видят итоговую сумму с доставкой?» Он описывает конкретный выбор пользователя и барьер.
Вторая: гипотеза, связанная с вопросом. Она объясняет, почему изменение должно повлиять на поведение, и задаёт логику интерпретации: если показать итоговую сумму на шаг раньше, меньше людей бросит оплату, потому что исчезнет неприятный сюрприз в конце.
Третья: решение для каждого исхода. Команда должна до запуска ответить, что сделает при росте метрики, при падении и при нулевом эффекте. Если на один из трёх исходов ответа нет, тест не готов: часть возможных результатов заранее некуда деть.
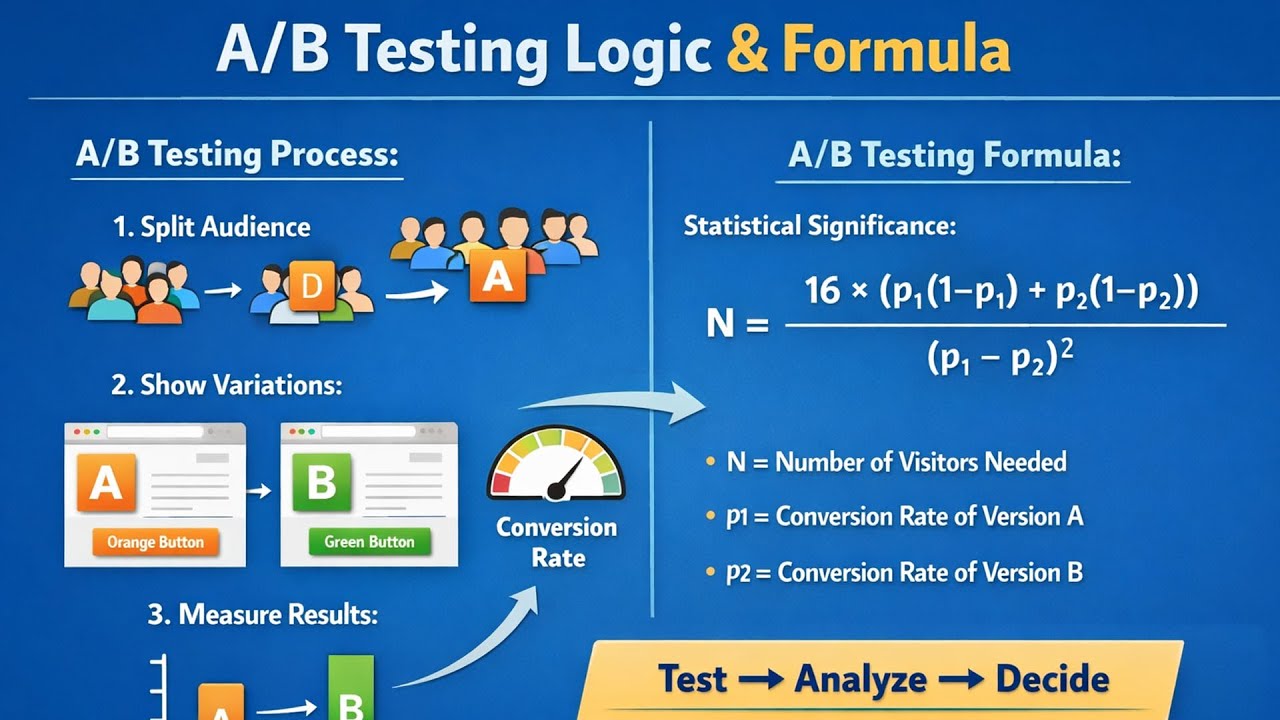
Пример с цифрами. Конверсия шага оплаты 4%. Команда хочет заметить рост хотя бы на 0,4 пункта, то есть на 10% относительно базы. Сколько нужно людей, чтобы такой рост не оказался случайностью? Есть грубая формула: n на группу ≈ 16 × p × (1-p) / d², где p означает нынешнюю конверсию, а d тот рост, который хотят заметить. Получаем 16 × 0,04 × 0,96 / 0,004² ≈ 38 400 посетителей на вариант. Шаг оплаты проходят 5 000 человек в день, по 2 500 на вариант. Значит, нужно около 15 дней, а с округлением до полных недель три недели. Полные недели нужны потому, что в выходные покупают другие люди и по-другому.
Решения записаны заранее. Рост на 0,4 пункта и больше: выкатываем на всех. Падение: откатываем и разбираем записи сессий, что именно отпугнуло. Нулевой эффект: оставляем старый вариант, потому что он проще в поддержке, и закрываем гипотезу о «сюрпризе в конце» как главной причине ухода. Ни один из трёх исходов не потребует нового спора.
Рядом с главной метрикой записывают защитные. Для теста на шаге оплаты это средний чек и доля возвратов: если итоговая сумма отпугнёт крупные заказы, конверсия может вырасти за счёт мелких, и выручка не изменится. Ещё одна проверка делается в первый же день: совпадает ли фактическое деление трафика с плановым. Если при делении 50 на 50 в одной группе оказалось 2 600 человек, а в другой 2 400, с распределением что-то не так, и выводы из такого теста делать нельзя, пока причина не найдена.
Подглядывание и подгонка превращают тест в ритуал
Вторая группа проблем возникает по ходу теста. Самая частая: тест останавливают в удобный момент. Если каждый день смотреть, «значим» ли результат, и останавливаться на первом успехе, ложных побед будет гораздо больше обещанных 5%. Каждая проверка даёт случайности ещё один шанс сойти за эффект. Йохари и соавторы в работе «Peeking at A/B Tests» (KDD 2017) предложили методы, при которых подглядывать можно без такой цены, но обычный калькулятор значимости к ним не относится.
Второй способ испортить тест: резать данные по сегментам, пока не найдётся красивый эффект. При 20 сегментах и уровне значимости 5% вероятность хотя бы одной случайной «значимой» разницы равна единице минус 0,95 в двадцатой степени, то есть около 64%. Найденный сегмент почти наверняка окажется миражом, если его не назвали до запуска.
Третий способ: менять метрику по ходу. Главная метрика не сдвинулась, зато выросла глубина просмотра, и команда объявляет победу. Рост одной метрики при этом часто сопровождается ущербом в другой, которую никто не смотрел.
Корень у третьей ошибки обычно в выборе метрики ещё до запуска. Ключевой часто становится метрика, которую удобно измерить, хотя нужна та, что влияет на решение. Клики по кнопке «Оформить заказ» считаются за секунды, оплаченные заказы приходят с задержкой и реже. Но решение о выкатке принимается ради заказов. Если тест показал рост кликов на 8% и ноль в оплатах, вариант просто переложил отказ на следующий шаг.
Неожиданно большой эффект заслуживает особого недоверия. Чаще всего за ним стоит сбой логирования, задвоенные события или бот-трафик в одной из групп, и проверить эти три вещи быстрее, чем готовить слайд с победой.
Тот же самообман слышно в репликах при обсуждении результатов: «давайте просто попробуем и посмотрим», «если цифры выросли, значит идея хорошая», «этот результат странный, давайте его не учитывать», «метрику можно поменять, так понятнее», «главное, что тест статистически значим». Все они говорят об одном: между экспериментом и выбором нет связи, и данные лишь украшают готовые аргументы.
Нулевой результат тоже знание
Промахи случаются и в замкнутом контуре, и большинство из них нормальны. Кохави и Томке в статье для HBR «The Surprising Power of Online Experiments» (2017) приводят данные Google и Bing: положительный результат дают лишь 10-20% экспериментов. В Microsoft примерно треть тестов оказывается положительной, треть нейтральной, треть отрицательной. Команда, у которой «выигрывает» каждый тест, скорее всего, плохо считает.
Нормальна ошибка в ожиданиях: ждали заметного эффекта, получили ноль. Это не провал, если понятно, почему эффект не проявился. Нормальна и ошибка формата: гипотеза верна, но изменение слишком слабое, чтобы повлиять на поведение. Такой результат подсказывает, как сделать следующий эксперимент сильнее.
Обратный пример из той же статьи показывает цену недоверия к экспериментам. Изменение заголовков рекламы в Bing полгода пролежало в бэклоге как малоприоритетное. Когда его наконец проверили, выручка выросла на 12%, что в США дало больше 100 млн долларов в год. Тест, который никто не хотел запускать, оказался одним из самых прибыльных.
Граница между нормальной осечкой и некомпетентностью простая. Пока после теста команда лучше понимает пользователя, контекст или ограничения продукта, эксперимент был полезен независимо от цифр. Когда эксперименты повторяются по шаблону, а выводы не накапливаются, тестирование становится ритуалом.
Выводы, которые никто не записал, придётся покупать снова
Самый дорогой способ обесценить эксперимент срабатывает уже после него. Тест завершили, решение приняли, а вывод остался в голове у двух человек и в слайде, который через полгода никто не найдёт. Потом приходит новый продакт и запускает тот же тест заново.
Посчитать цену несложно. Если тест на шаге оплаты занял три недели трафика и неделю работы аналитика и разработчика, повтор обходится в те же ресурсы. При потоке 30 экспериментов в квартал даже пять повторов в год съедают больше месяца трафика, который мог бы проверить новые гипотезы.
Журнал экспериментов решает это без сложных систем. Хватает таблицы из шести колонок: вопрос, гипотеза, главная метрика, результат с интервалом, принятое решение, что мы теперь знаем о пользователе. Последняя колонка важнее всех: именно она превращает отдельные тесты в накопленное знание. Перед каждым новым запуском продакт тратит пять минут на поиск по журналу, и часть идей отпадает сама.
Исследование, разработка и споры: три места, где логика ломается по-разному
На этапе исследования A/B-тест часто подменяет само исследование. Команда сразу тестирует решения, не разобравшись, почему люди так себя ведут. Гипотезы получаются поверхностными. А результат потом объясняют задним числом: рост подтверждает идею, падение списывают на шум.
Если команда не знает, почему люди бросают корзину, пять тестов с разными цветами кнопки дадут пять случайных ответов. Десяток интервью с теми, кто бросил, обычно дешевле и быстрее подскажет, какую версию ответа вообще стоит проверять. Зрелый подход проверяет тестом конкретную версию, и тогда любой исход расширяет понимание проблемы.
В разработке тесты спорят с планом. Решение уже стоит в roadmap, эксперимент нужен для галочки, поэтому его заканчивают досрочно или не смотрят на результат. Команда быстро усваивает, что тесты ни на что не влияют, и перестаёт доверять данным. В зрелом процессе заранее допускают, что эксперимент может поменять планы, и оставляют в roadmap место для такого исхода.
В коммуникации проблема видна по спорам о цифрах. Разные отделы трактуют один результат по-своему и используют данные как оружие: каждый выбирает срез под свою позицию. Правила интерпретации, записанные до запуска, сужают пространство для таких споров сильнее любого дашборда.
Серия под один вопрос и общий стандарт для отделов
Возьмём собирательный онлайн-сервис, таких много. Он регулярно тестировал изменения интерфейса, и почти каждый эксперимент показывал локальный рост отдельных метрик, а удержание стояло на месте. Формально тесты были корректны, отчёты убедительны. На ретроспективе команда признала, что проверяла элементы интерфейса и ни разу не спросила о причинах поведения.
Подход изменили: один бизнес-вопрос на серию тестов. Все гипотезы серии объясняли один и тот же выбор пользователя, мелкие тесты объединили в более крупные изменения сценариев. Часть тестов показала отсутствие эффекта, и команда отказалась от нескольких привычных решений. Экспериментов стало меньше, примерно вдвое. Удержание через несколько месяцев выросло, но связывать рост напрямую со сменой подхода без отдельной проверки не стоит.
Во втором типичном случае проблема уходит в отношения между отделами. В B2B-продукте продажи, маркетинг и продукт запускали эксперименты, чтобы подтвердить свою точку зрения. Продакт отвечал за процесс, но не мог навязать единые правила интерпретации. Решением стал простой стандарт: каждый тест начинается с бизнес-вопроса и заканчивается заранее определённым решением. Многие идеи не прошли этот фильтр, и число экспериментов за квартал упало примерно с 25 до 9. Оставшиеся перестали быть аргументами в споре и стали входными данными для решений.
Когда A/B-тест не нужен
Против всей этой дисциплины есть честный аргумент: культура экспериментов замедляет продукт. Пока команда три недели ждёт значимости, конкурент выкатил три изменения. Да и не всё можно проверить тестом.
В ряде случаев это правда. Если для нужного эффекта требуется больше трафика, чем приходит за четыре-шесть недель, тест не наберёт мощность.
Возьмём B2B-продукт с 300 активными аккаунтами, по 150 в группе, и метрику с базой 20%. С такими маленькими группами доля сама по себе гуляет на несколько пунктов. Надёжно увидеть можно только эффект порядка 13 пунктов. Разницу в 2 пункта такой тест не заметит никогда.
Стратегические и необратимые решения, вроде смены модели монетизации, тоже плохо тестируются на части аудитории. А в продуктах с сетевым эффектом пользователи двух вариантов влияют друг на друга, и простое деление на группы даёт искажённый результат.
Правило решения получается такое. Если расчётная выборка набирается за четыре недели и решение обратимо, тестируйте. Если не набирается, переходите к качественным методам: интервью, записям сессий, сравнению до и после с явной оговоркой о сезонности. Если решение дешёвое и легко откатывается, иногда честнее просто выкатить его и следить за ключевой метрикой.
Шесть вопросов перед запуском и одна метрика для квартала
Перед каждым тестом достаточно шести вопросов. Если на какой-то нет честного ответа, тест лучше отложить и сначала записать недостающее.
- Какой бизнес-вопрос снимает этот эксперимент?
- Зафиксирована ли гипотеза до запуска?
- Какое изменение поведения пользователя мы ожидаем?
- Выбрана ли ключевая метрика и защитные метрики заранее?
- Что мы сделаем при росте, падении и нулевом эффекте?
- Хватит ли трафика, чтобы набрать выборку за разумный срок?
Раз в квартал полезно посмотреть на весь поток экспериментов целиком. Главная метрика здесь: доля тестов, результат которых изменил хоть одно решение, включая решение не делать. Если она ниже половины, команда тестирует ради активности. Ограничитель: время от идеи до решения. Если дисциплина записей растянула его вдвое, правила стоит упростить.
Показательно, как мало в этих вопросах статистики. Ошибку в расчёте выборки команда обычно находит сама. Спор о том, что считать успехом, когда цифры уже пришли, случается почти везде, где этот вопрос не закрыли до запуска.